AI 开发正在从“能不能调用模型”,进入“能不能稳定地把能力交付给用户”的阶段。真正落地一个 AI 功能,往往不难写出第一段代码,难的是让它在模型切换、流量上涨、成本波动和团队协作中依旧可控。
这篇文章不聊空泛趋势,只梳理一条适合大多数产品团队的实践路径:从一次模型调用开始,逐步搭出可维护、可扩展的 AI 能力。
第一步:把模型能力当作产品依赖,而不是临时工具
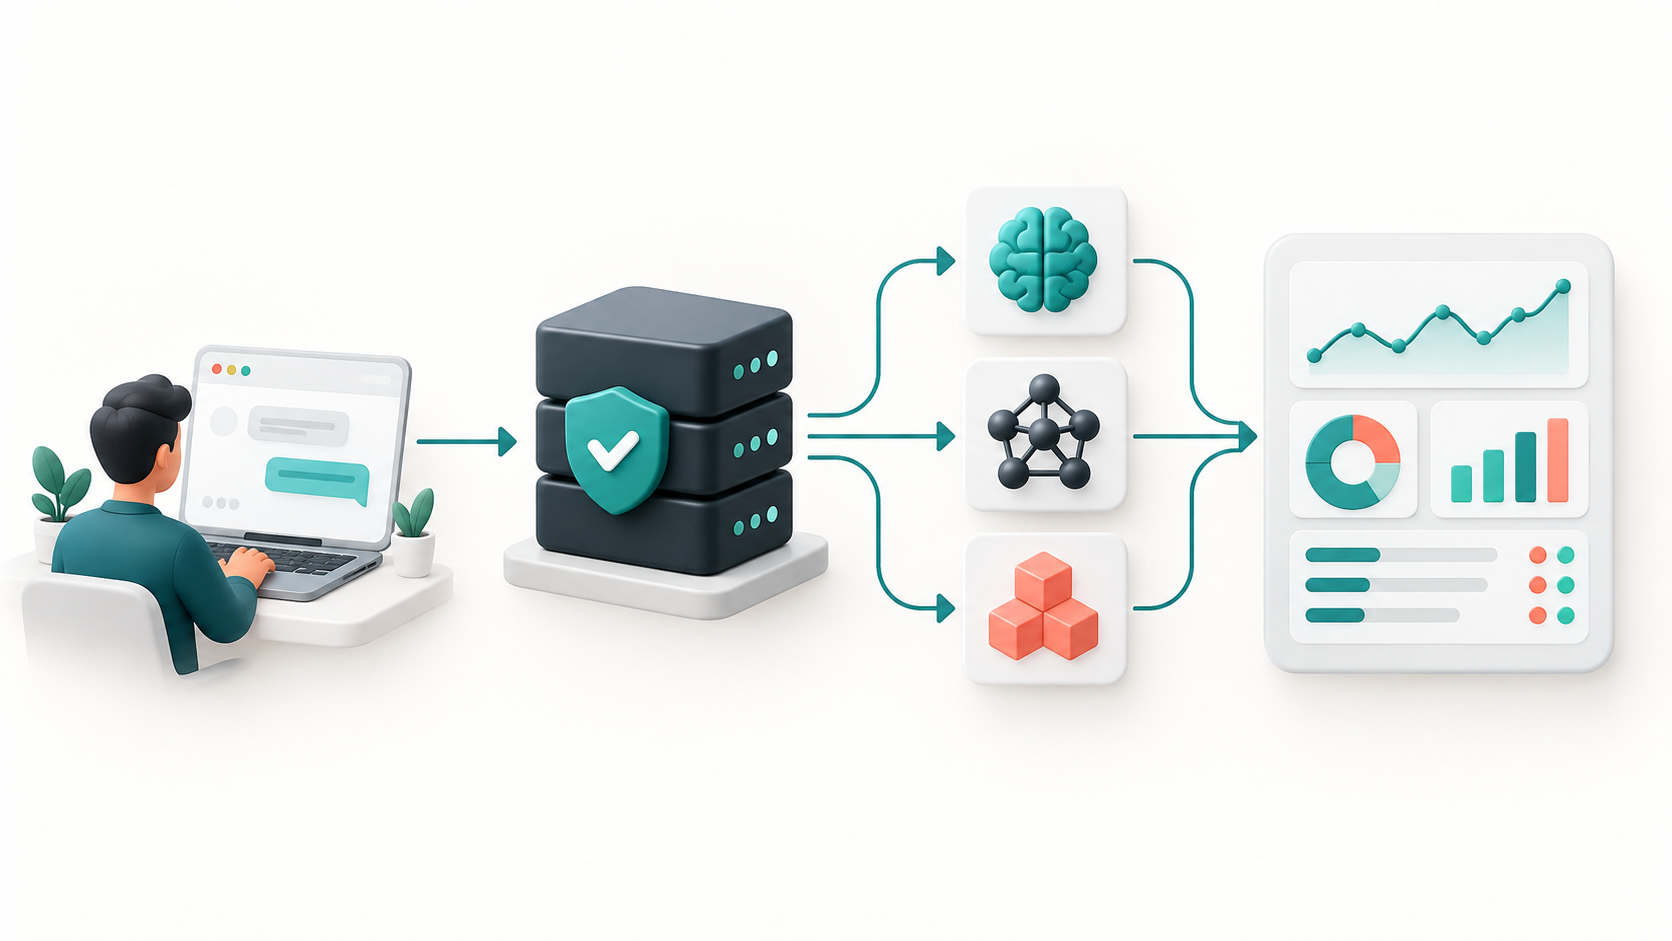
开发早期,直接把某一家模型服务写进业务代码很常见。但当产品开始有真实用户后,模型可用性、限流、版本变化和计费方式都会变成业务风险。更稳妥的做法是把“模型调用”抽成独立能力层:
- 业务服务只表达任务:摘要、问答、代码生成、图片理解等;
- 模型层负责路由、超时、重试、用量统计和失败降级;
- 模型供应商可替换,业务接口保持稳定。
这样做的价值很直接:模型策略变化时,不需要让每一个业务模块跟着改代码。
第二步:为每一个调用设置“边界”
AI 请求天然存在不确定性。输入可能很长,输出可能很慢,单次成本也可能突然升高。因此,生产环境至少要明确四类边界:
- 超时边界:为不同任务设置合理的等待时间,避免一个慢请求拖住整个页面或队列。
- 成本边界:限制最大输入、最大输出和单用户预算,先保护业务,再谈体验优化。
- 并发边界:对账号、用户或任务类型做限流,避免高峰期把可用额度一次打空。
- 内容边界:对输入做校验,对输出保留必要的审核和兜底逻辑。
这些限制并不是给产品“加束缚”,而是在把不可控的模型行为变成可预期的服务能力。
第三步:用观测数据指导模型选择
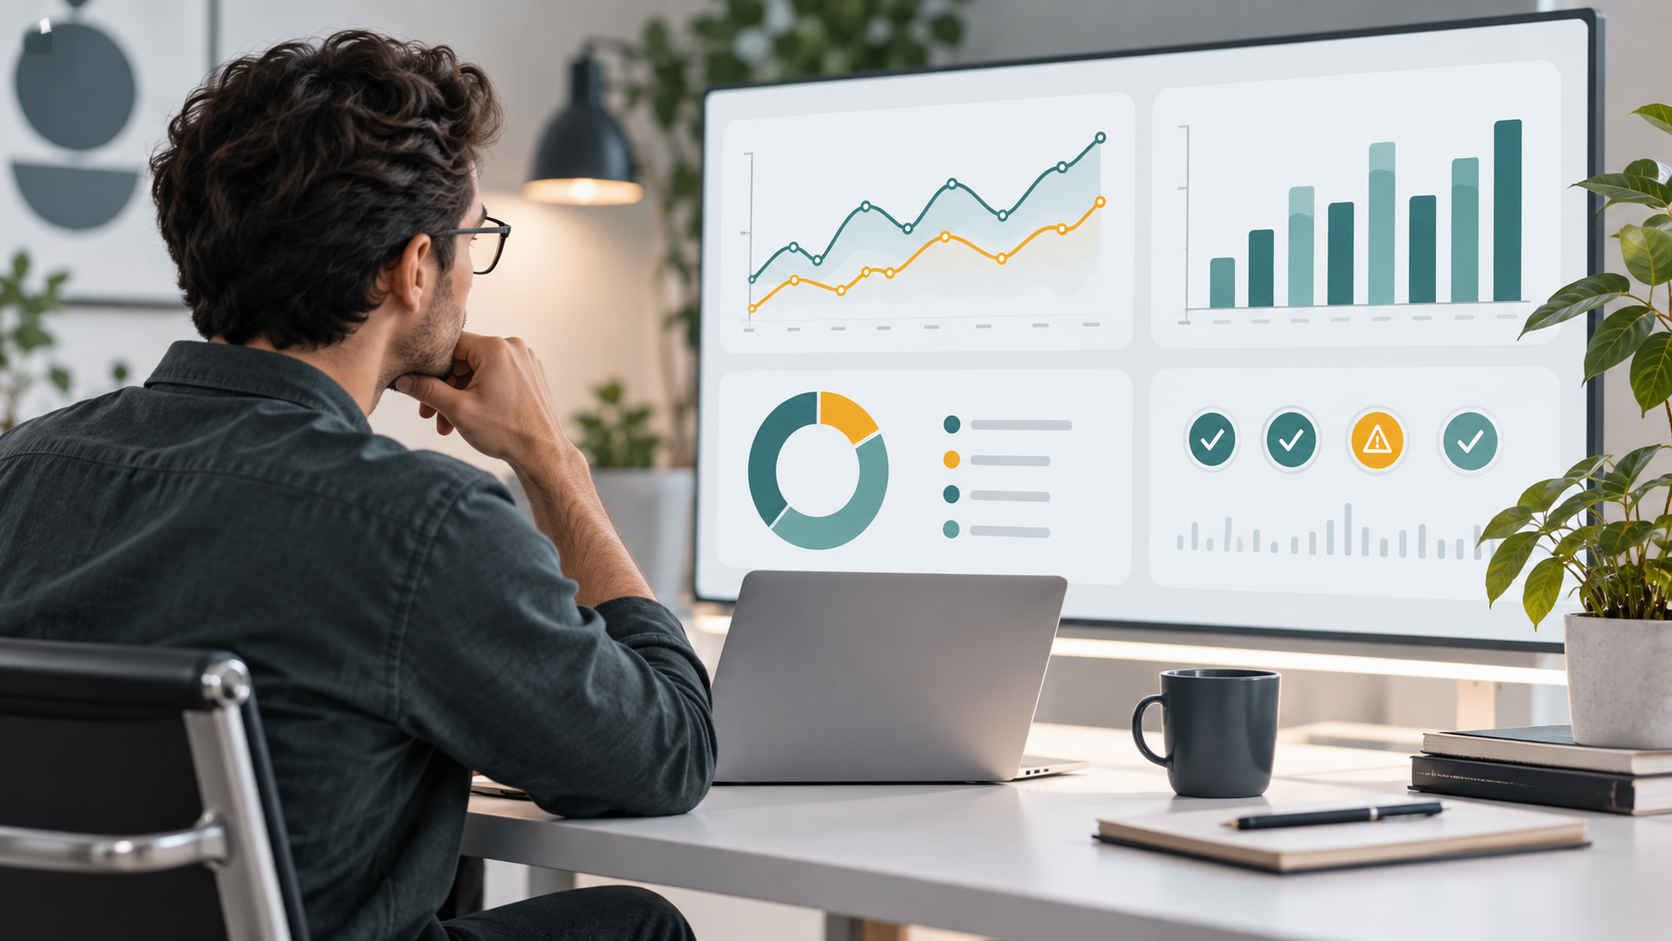
不要只看模型名称或宣传参数。真正值得持续跟踪的是:成功率、首字延迟、总耗时、输入输出 Token、单次成本,以及不同任务下的用户满意度。
有了这些数据,团队可以更务实地做决策:复杂推理交给能力更强的模型,批量提取和常规问答选择更具性价比的模型;当某个渠道不稳定时,自动切换到备用方案。模型不再是固定选择,而是一组可以按任务动态调度的资源。
第四步:让密钥、权限与账单可管理
当团队成员、客户或多个项目开始共享 AI 能力时,最容易失控的往往不是代码,而是密钥和费用。建议把 API 密钥按用途和人员拆分,并为不同用户配置独立额度、并发和调用权限。
一套集中式的 AI API 管理层可以帮助团队完成这些事情:统一接入不同模型渠道、分发密钥、按用户统计用量、控制余额与预算,并快速追踪异常请求。对于开发者而言,它把大量重复的接入和运营工作收拢到一个地方。
从一次调用,到可持续的 AI 产品
AI 开发的核心竞争力,不只是选到一个好模型,而是把模型能力可靠地接进产品。先建立稳定的调用边界,再用数据持续优化路由和成本,团队才能把精力留给真正有价值的用户体验。
如果你正在搭建 AI 应用,或希望让团队的模型接入、密钥管理和用量统计更清晰,可以从统一 API 接入开始。把底层复杂度收好,产品迭代才会更快。
发表回复