标签: API 接入

  • 把「AI 写论文」做成产品功能:给教学系统接入智能写作模块

    把「AI 写论文」做成产品功能:给教学系统接入智能写作模块

    前两篇从教师视角讲了 AI 怎么辅助写教育论文。如果换个视角——你是园所平台、教研工具或师范类产品的开发者,你会发现「论文助手」已经是一个被验证过的刚需功能:用户有真实的截止日期、愿意为「省时间」付费,而且场景足够标准,非常适合做成产品模块。

    这篇文章给出一个最小可用架构:三个业务端点 + 一条多模型路由策略,百行以内的代码就能上线。
    教学系统接入 AI 能力:从教材与教法到智能写作

    一、三个业务端点,覆盖论文写作全流程

    不要做一个「输入题目输出全文」的黑盒——教师需要的是可控的分步辅助。产品形态收敛为三个端点:

    • POST /outline:输入选题与观察素材,输出三级大纲(强推理模型);
    • POST /section:输入大纲节点 + 一手材料,输出该节初稿(长文写作模型);
    • POST /polish:输入成稿段落,输出修改建议与降 AI 味改写(便宜模型批量跑)。

    二、路由策略:让贵的模型干贵的活

    三个端点对模型的要求完全不同,这正是多模型路由的价值。(统一接入层的完整实现见前面这篇:《多模型统一接入层实战》):

    端点任务特征路由目标理由
    /outline结构化推理GPT-6 Astra 级旗舰大纲质量决定全文上限
    /section长文写作、上下文长Claude Fable 5.1 级长文模型长上下文与文风稳定
    /polish规则化改写、批量DeepSeek V4.1-Flash 级开源模型地板价,批处理无压力
    ROUTES = [
        ModelRoute("gpt-6-astra",      openai_client,  1, ("outline",)),
        ModelRoute("claude-fable-5.1", claude_client,  1, ("section",)),
        ModelRoute("deepseek-v4.1",    deepseek_client, 2, ("polish", "section")),
    ]
    
    @app.post("/section")
    def gen_section(req: SectionReq, gateway=Depends(get_gateway)):
        # 路由器自动匹配 "section" 强项模型,失败自动降级到 deepseek
        reply = gateway.complete(
            messages=build_section_prompt(req),
            task="section",
            temperature=0.6,
            max_tokens=2400,
        )
        return {"draft": reply, "model": gateway.last_used}

    两个工程细节值得强调:

    • 提示词进配置不进代码:幼教场景的提示词会随教研反馈频繁迭代,放配置中心或数据库,热更新不用发版;
    • 材料越界裁剪:教师上传的观察记录可能很长,超模型窗口前先做分段摘要,摘要这种粗活也路由给便宜模型。
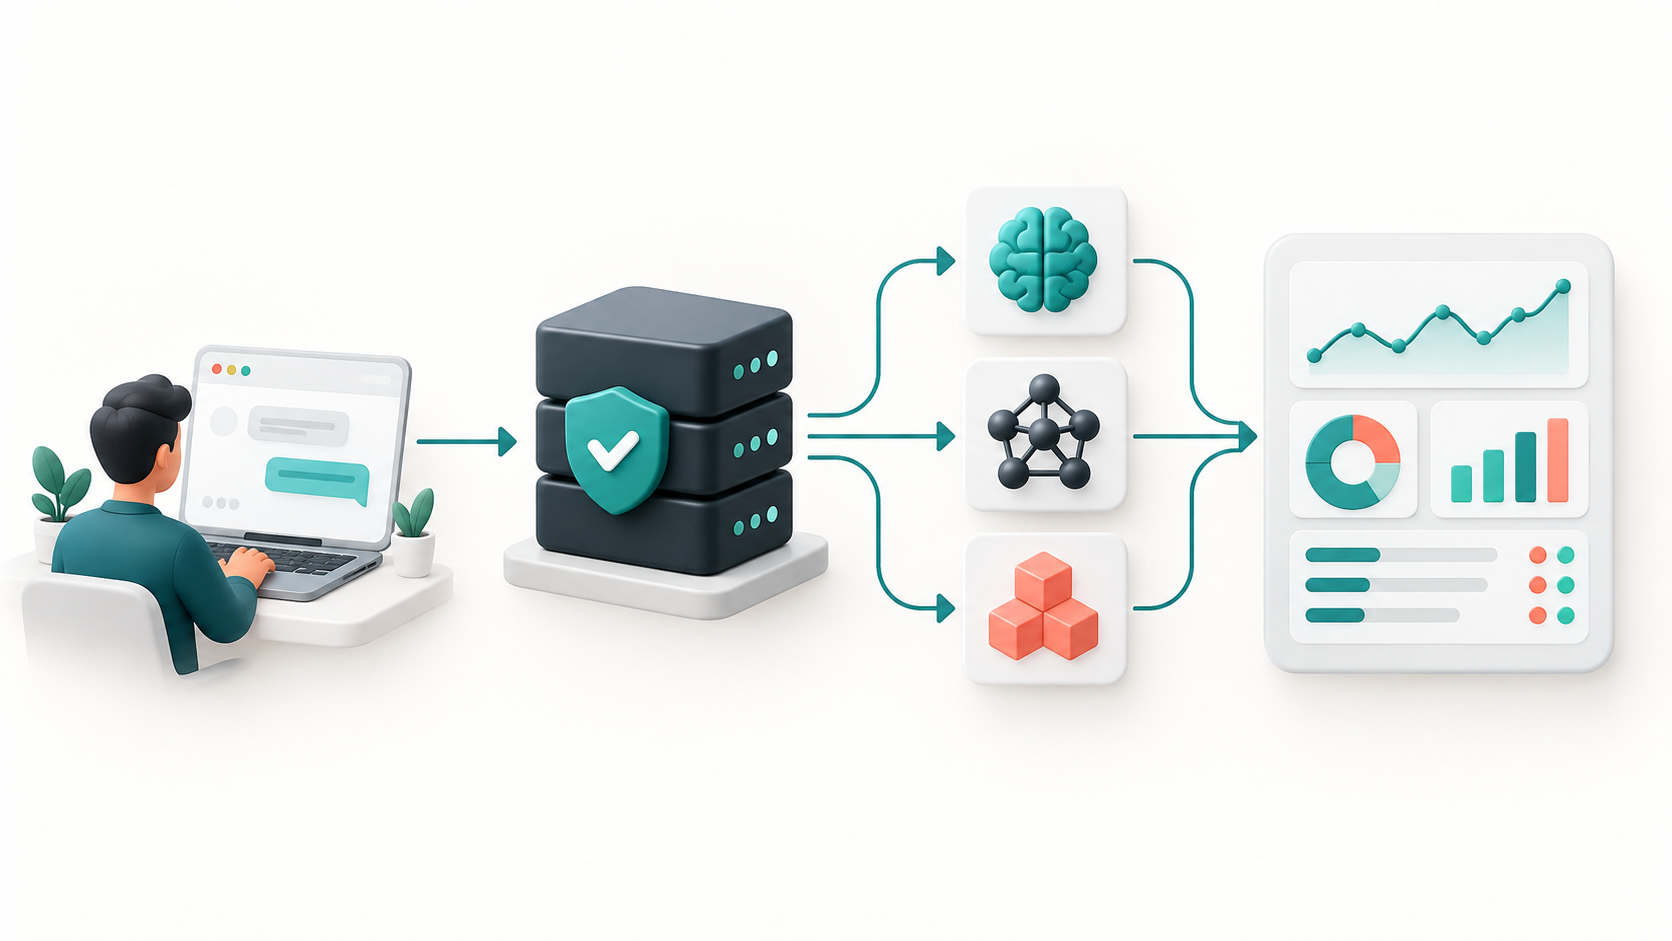
    统一接入层:三个业务端点按任务路由到不同大模型

    三、成本账:路由能省多少

    以一次完整论文辅助(1 次大纲 + 6 节正文 + 3 轮润色)估算 token 用量:

    端点输入/输出 tokens(估)全旗舰方案路由方案
    /outline × 33K / 2K旗舰价旗舰价
    /section × 1854K / 30K旗舰价长文模型为主,溢出降级
    /polish × 927K / 20K旗舰价开源模型地板价

    按 2026 年 9 月的主流价格估算,路由方案的总成本约为全旗舰方案的三分之一,而教师可感知的质量差异主要集中在大纲环节——恰好是路由策略里「该贵就贵」的那部分。(价格为公开牌价的量级估算,实际以你的用量分布为准。)
    开发者正在为教学系统接入智能写作模块

    四、一条红线:产品要替教师守住学术规范

    做成产品后,你的默认设置就是几千名教师的写作习惯。三件事建议做成产品能力而非免责条款:

    • 文献强制核验入口:/outline 返回的每一条「建议检索」都附知网检索链接,而不是让模型直接给参考文献;
    • AI 痕迹提示:导出时可选标注「AI 辅助生成初稿、经作者校订」,这正在成为期刊的普遍要求;
    • 材料不训练承诺:教师的观察记录涉及儿童隐私,选 API 供应商时确认数据不用于训练。

    上面这三段代码要真正跑稳,底层需要一条可靠的多模型通道。拓瑞智能 trui88.com 提供多模型统一 API:路由、重试、降级、用量统计开箱即用,你只需关心「大纲、正文、润色」这三个业务接口。注册即送体验额度,把模型层的脏活累活交给平台,把精力留给真正的教学产品。
  • 多模型统一接入层实战:一套接口调度 GPT-6、Claude、DeepSeek

    多模型统一接入层实战:一套接口调度 GPT-6、Claude、DeepSeek

    先讲一个真事:上个月隔壁团队凌晨三点被告警叫醒——不是他们的代码出了问题,而是他们调用的某家模型商触发了限流,业务请求批量失败。2026 年做 AI 应用,单一模型依赖已经不是技术选型问题,是业务连续性风险。

    解法业界早已收敛:在业务和模型之间加一层「统一接入层」。这篇文章用 100 多行 Python,把它的核心逻辑讲透、写全。

    统一接入层:一个入口,分流到多个大模型

    一、为什么统一接入层成了标配

    它要解决的三件事,恰好是多模型架构的三大痛点:

    • 统一接口:业务侧只认一个 API 形状,底层换模型、加模型不改一行业务代码。
    • 智能路由:按任务类型、成本、延迟把请求分发到最合适的模型。
    • 故障切换:主模型限流或超时,自动重试备用通道,业务侧完全无感。

    下面这张动画就是一个请求的完整旅程:主通道 DeepSeek 处理中触发 429 限流,接入层检测失败后自动切到备用通道 Claude,业务侧甚至不知道发生过一次故障。

    动画:一次请求的路由与故障自动切换全过程

    二、最小可用实现(Python)

    先定义模型注册表——每个模型声明自己的强项与优先级:

    from dataclasses import dataclass, field
    
    @dataclass
    class ModelRoute:
        name: str          # 模型标识
        client: object     # 对应的 API 客户端(统一封装后)
        priority: int      # 数值越小优先级越高
        strengths: tuple   # 擅长的任务类型
        rpm_limit: int = 60
    
    REGISTRY = [
        ModelRoute("deepseek-v4.1-flash", deepseek_client, 1,
                   ("summary", "extract", "batch"), rpm_limit=300),
        ModelRoute("claude-fable-5.1",    claude_client,  2, ("long-doc", "chat")),
        ModelRoute("gpt-6-astra",         openai_client,  3, ("agent", "coding")),
    ]

    路由器按「任务类型匹配 → 优先级排序 → 健康检查」三级筛选,失败自动降级到下一个:

    import time, itertools, logging
    
    logger = logging.getLogger("gateway")
    
    class UnifiedGateway:
        def __init__(self, registry, cooldown=30):
            self.registry = sorted(registry, key=lambda r: r.priority)
            self.cooldown = cooldown
            self._failed_until = {}          # 模型 -> 熔断截止时间
    
        def _pick(self, task):
            now = time.time()
            candidates = [r for r in self.registry
                          if self._failed_until.get(r.name, 0) < now
                          and (not task or task in r.strengths or not r.strengths)]
            return candidates or [r for r in self.registry
                                  if self._failed_until.get(r.name, 0) < now]
    
        def complete(self, messages, task=None, **kw):
            last_err = None
            for route in self._pick(task):
                try:
                    return route.client.chat(messages, **kw)
                except RateLimitError as e:
                    # 限流:熔断一段时间,立即切下一个
                    self._failed_until[route.name] = time.time() + self.cooldown
                    logger.warning("%s 限流,熔断 %ss,降级", route.name, self.cooldown)
                    last_err = e
                except (TimeoutError, ConnectionError) as e:
                    logger.warning("%s 网络异常,降级: %s", route.name, e)
                    last_err = e
            raise last_err

    业务侧从此只写一行:

    gateway = UnifiedGateway(REGISTRY)
    
    # 自动选摘要类最优模型;失败自动降级,业务无感
    reply = gateway.complete(messages, task="summary")
    • 熔断窗口(cooldown)避免每个请求都去撞限流,30 秒足够让限流窗口重置;
    • 降级链路要提前演练——上线前手动触发一次主模型 429,确认备用通道真的接得住;
    • 日志必须带模型名与耗时,这是后面做成本分析的数据基础。
    开发者正在调试统一接入层代码

    三、别忽略密钥与成本治理

    接入层跑起来只是及格线,长期运行的团队还要管住两件事:

    • 密钥治理:密钥只存在服务端环境变量或密钥管理服务,按模型、按业务域拆分,任何一把泄露都不至于全军覆没;
    • 用量监控:按模型记录 token 消耗与费用,设置单日预算告警。没有看板的成本优化都是玄学。
    多模型用量与成本监控看板

    四、造轮子,还是直接用?

    自建的接入层胜在可控,但你要自己维护模型适配、熔断策略、密钥轮换和监控看板——这些工程量对多数团队并不划算。如果你的目标是把时间花在业务上,直接用成熟的多模型网关是更务实的选择。

    如果你不想自己维护这套接入层,也可以直接使用已经打磨好的版本:拓瑞智能 trui88.com 提供多模型统一 API——路由、重试、降级、用量统计开箱即用,业务侧始终只面对一个稳定的接口。注册即送体验额度,把凌晨三点的告警留给平台,把时间留给你真正的业务。

  • AI 开发实战:从模型调用到产品上线的 4 个关键步骤

    AI 开发实战:从模型调用到产品上线的 4 个关键步骤

    AI 开发正在从“能不能调用模型”,进入“能不能稳定地把能力交付给用户”的阶段。真正落地一个 AI 功能,往往不难写出第一段代码,难的是让它在模型切换、流量上涨、成本波动和团队协作中依旧可控。

    这篇文章不聊空泛趋势,只梳理一条适合大多数产品团队的实践路径:从一次模型调用开始,逐步搭出可维护、可扩展的 AI 能力。

    开发者在使用人工智能工具进行软件开发
    让模型能力成为可靠的产品能力,是 AI 开发走向生产环境的关键。

    第一步:把模型能力当作产品依赖,而不是临时工具

    开发早期,直接把某一家模型服务写进业务代码很常见。但当产品开始有真实用户后,模型可用性、限流、版本变化和计费方式都会变成业务风险。更稳妥的做法是把“模型调用”抽成独立能力层:

    • 业务服务只表达任务:摘要、问答、代码生成、图片理解等;
    • 模型层负责路由、超时、重试、用量统计和失败降级;
    • 模型供应商可替换,业务接口保持稳定。

    这样做的价值很直接:模型策略变化时,不需要让每一个业务模块跟着改代码。

    应用通过统一接口连接多个 AI 模型并进行管理
    统一接入层把业务需求、模型路由和运营管理分开。

    第二步:为每一个调用设置“边界”

    AI 请求天然存在不确定性。输入可能很长,输出可能很慢,单次成本也可能突然升高。因此,生产环境至少要明确四类边界:

    1. 超时边界:为不同任务设置合理的等待时间,避免一个慢请求拖住整个页面或队列。
    2. 成本边界:限制最大输入、最大输出和单用户预算,先保护业务,再谈体验优化。
    3. 并发边界:对账号、用户或任务类型做限流,避免高峰期把可用额度一次打空。
    4. 内容边界:对输入做校验,对输出保留必要的审核和兜底逻辑。

    这些限制并不是给产品“加束缚”,而是在把不可控的模型行为变成可预期的服务能力。

    第三步:用观测数据指导模型选择

    不要只看模型名称或宣传参数。真正值得持续跟踪的是:成功率、首字延迟、总耗时、输入输出 Token、单次成本,以及不同任务下的用户满意度。

    有了这些数据,团队可以更务实地做决策:复杂推理交给能力更强的模型,批量提取和常规问答选择更具性价比的模型;当某个渠道不稳定时,自动切换到备用方案。模型不再是固定选择,而是一组可以按任务动态调度的资源。

    开发者查看人工智能服务的用量、延迟和成本数据
    用量、延迟、成本和成功率,是选择与调度模型的真实依据。

    第四步:让密钥、权限与账单可管理

    当团队成员、客户或多个项目开始共享 AI 能力时,最容易失控的往往不是代码,而是密钥和费用。建议把 API 密钥按用途和人员拆分,并为不同用户配置独立额度、并发和调用权限。

    一套集中式的 AI API 管理层可以帮助团队完成这些事情:统一接入不同模型渠道、分发密钥、按用户统计用量、控制余额与预算,并快速追踪异常请求。对于开发者而言,它把大量重复的接入和运营工作收拢到一个地方。

    从一次调用,到可持续的 AI 产品

    AI 开发的核心竞争力,不只是选到一个好模型,而是把模型能力可靠地接进产品。先建立稳定的调用边界,再用数据持续优化路由和成本,团队才能把精力留给真正有价值的用户体验。

    如果你正在搭建 AI 应用,或希望让团队的模型接入、密钥管理和用量统计更清晰,可以从统一 API 接入开始。把底层复杂度收好,产品迭代才会更快。

    访问中转站,了解可用的 AI 模型接入方式。