分类: 行业动态

  • AI 手机怎么挑:看懂 NPU 算力、内存、模型大小这 3 个参数

    AI 手机怎么挑:看懂 NPU 算力、内存、模型大小这 3 个参数

    买手机时销售会说「这颗芯片 NPU 算力 XX TOPS,端侧能跑大模型」。听起来很唬人,但TOPS 高不等于体验好——真正决定你能跑什么模型、跑得多顺的,是另外几件事。

    先把三个参数讲明白,再看怎么选。
    手机内部 NPU 芯片与端侧 AI 算力示意

    参数一:NPU 算力(TOPS)——决定「快不快」

    TOPS 是芯片每秒能做的万亿次运算,衡量的是推理速度。它影响的是「一句话生成要等几秒」,但不决定「能不能跑某个模型」。厂商爱拿它当卖点,因为数字好看、还能逐年翻倍。

    参数二:内存(RAM)——决定「能不能跑」

    这是最容易被忽略、也最关键的一项。端侧模型要常驻内存,内存不够,模型根本加载不起来,算力再高也没用。粗略对应:4-bit 量化下,7B 模型约需 4GB 左右常驻,更大的模型需要 8GB 乃至更多。想让手机流畅跑端侧模型,内存比 TOPS 更值得看。

    参数三:模型大小与量化——决定「跑得动什么」

    模型不是越大越好,而是要看厂商适配了哪一档。常见的端侧档位大致是:小模型(1B–3B)做输入预测、摘要;中模型(7B 级)做对话、写作;再往上就得交给云端。

    档位典型内存端侧能跑的模型实际体验
    入门8GB1B–3B 小模型输入法联想、简单摘要、通话转写
    主流12GB7B 级(4-bit 量化)本地对话、写作润色、图片消除
    旗舰16GB 及以上7B–13B(量化)较长文本理解、多轮对话更稳

    选购建议:别被 TOPS 带偏

    • 先看内存:想真正用上本地大模型,12GB 起步,16GB 更从容;
    • 再看厂商适配:同样 16GB,厂商有没有把模型压进系统层、输入法/相册/录音里能不能直接用,比纸面算力更重要;
    • 最后看 TOPS:它决定快慢,在前两项达标的前提下越大越好。

    还有一个现实:重活永远在云端。长文档、复杂推理、最新模型能力,端侧追不上,最终还是要把请求发出去——这一点我们在 《端侧大模型崛起》里拆过端侧与云端的分工边界。想看具体机型的形态差异,可参考我们的 折叠屏四强对比。

    想自己上手对比不同模型的端侧/云端表现,可以在 拓瑞智能 trui88.com 用一把 API Key 调通 GPT-6、Claude、DeepSeek,按用量计费、一个后台统一切换,先在云端把效果跑通,再判断哪些值得下沉到手机本地。注册即送体验额度。
  • 苹果折叠屏来了:和三星、小米、华为同台比,谁更值得等?

    苹果折叠屏来了:和三星、小米、华为同台比,谁更值得等?

    2026 年买折叠屏,第一次出现了「选择题」:苹果入场,三星、小米、华为早就在牌桌上。过去大家聊折叠屏基本只看三星,现在四家各有杀招——有人拼生态、有人拼成熟度、有人拼性价比、有人拼国产自研。

    下面把四家按同维度摆在一张表里。先说清楚口径:三星 / 小米 / 华为为已上市机型公开信息;苹果项为供应链与媒体公开爆料,尚未正式发布,最终以官方为准。

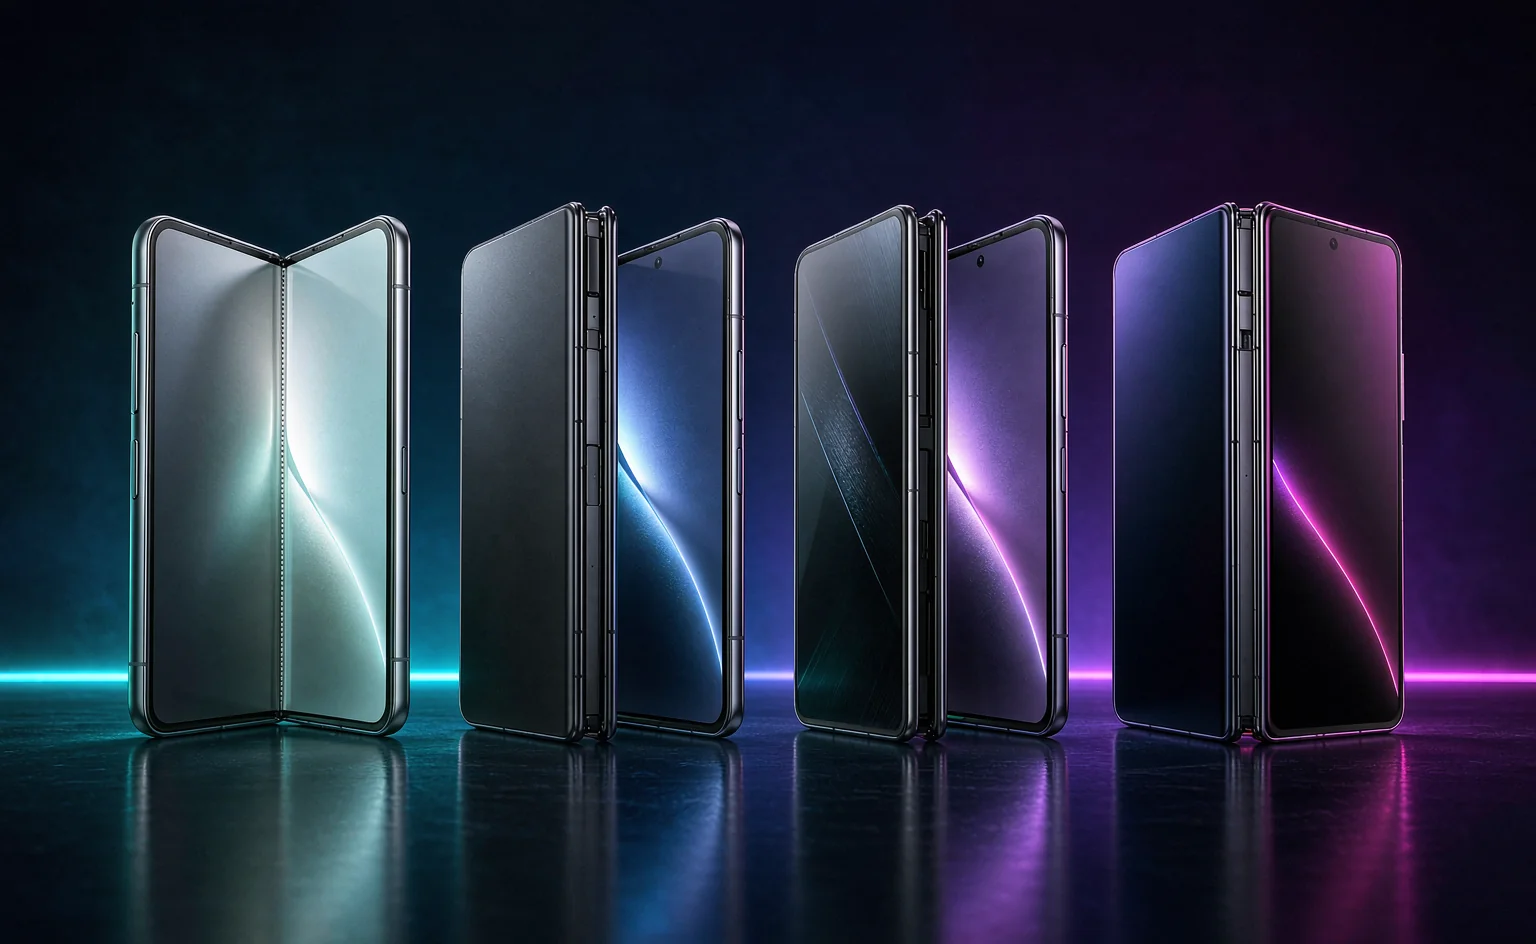
    苹果、三星、小米、华为四款折叠屏手机对比示意

    一、一张表看清四强

    维度苹果(传闻)三星 Galaxy Z Fold华为 Mate X小米 MIX Fold
    形态书本式内折(传闻)书本式内折内折 / 三折(XT)书本式内折
    内屏约 7.8 寸(传闻)约 7.6 寸约 7.9 寸约 7.9 寸
    外屏约 5.5–6 寸(传闻)约 6.3 寸约 6.4 寸约 6.5 寸
    芯片A 系列(未发布)骁龙 8 至尊版麒麟 / 鸿蒙骁龙 8 至尊版
    系统生态iOS / iPadOS 融合Android / One UI鸿蒙 HarmonyOSAndroid / 澎湃 OS
    AI 能力Apple IntelligenceGalaxy AI鸿蒙 AI澎湃 AI
    价格区间传闻 1.5 万+约 1.3–1.5 万约 1.0–1.3 万约 0.9–1.1 万
    上市节奏2026 待发布(传闻)已上市已上市已上市

    横向看完,结论很清楚:三星 / 华为 / 小米是「现在就能买」,苹果是「值得等但最贵最晚」。

    二、各家的真实卖点

    苹果:生态融合是它的护城河

    苹果做折叠屏最大的变量不是硬件,而是把 iPhone、iPad、Mac 的体验无缝揉进一块可折叠屏。传闻中的 App 连续布局、分屏逻辑、与 Apple Pencil / 键盘的联动,是安卓阵营短期内追不上的。代价是价格最高、上市最晚,首批供应链成熟度也要等真机检验。

    三星:折叠屏老兵,铰链和屏幕最稳

    三星做了这么多代折叠屏,铰链耐久、屏幕折痕控制、UTG 超薄玻璃都是行业标杆;Galaxy AI 把通话翻译、笔记摘要、圈选搜索做进了系统层,开箱即用。适合「现在就要可靠」的人。

    华为:鸿蒙生态 + 三折叠创新

    华为的差异化在于鸿蒙全场景协同——手机、平板、车机一拉即合;Mate XT 三折叠更是把形态玩出了新花样。对已经深度在华为生态里的用户,几乎没有替代选项。

    小米:性价比 + 轻薄

    小米走的是「旗舰配置、更低价位、更轻更薄」路线,做工和影像这几年进步明显。预算有限又想要大屏体验,小米是四家里最友好的入场券。

    三、四类人,怎么选

    • 不差钱 + 已是果链 + 能等:等苹果,生态融合的体验是它独有的;
    • 现在就要可靠折叠屏:选三星,铰链和屏幕成熟度高、AI 功能开箱即用;
    • 鸿蒙生态 / 国产优先:选华为,三折叠还能尝鲜新形态;
    • 预算敏感 / 想要轻薄:选小米,旗舰配置折价最狠。

    四、一个被忽略的点:折叠屏也吃 AI

    折叠屏的大屏分屏,恰恰是多窗口 AI 助手最好的载体——一边看文档一边让 AI 总结、一边视频会议一边让 AI 记要点。这也呼应我们聊过的端侧与云端分工:《端侧大模型崛起》里讲的逻辑,在手机上同样成立——轻量隐私任务本地跑,重推理交给云端。

    无论最后选哪家,参数对比、选型决策这种事都能交给 AI 先做一版草稿。在 拓瑞智能 trui88.com 一把 API Key 调通 GPT-6、Claude、DeepSeek,让模型帮你拉参数表、写对比、出选购建议,按用量计费、一个后台统一切换。注册即送体验额度,今晚就能把四家参数丢进去跑一张对比表。

  • 端侧大模型崛起:企业还要不要依赖云端 API 接入?

    端侧大模型崛起:企业还要不要依赖云端 API 接入?

    2026 年最容易被误读的一句话,是「端侧大模型起来了,云上那一套可以退休了」。确实,旗舰手机能流畅跑 7B 参数模型、桌面显卡能跑 14B 甚至更大的本地模型,「数据不出设备」第一次变得可行。但把话讲全,应该是:端侧补齐了云端的短板,却没有取代云端的价值。

    下面用一张表把两者的能力边界摆清楚,再谈企业到底该怎么选。

    端侧设备与云端服务器的 AI 能力对比示意

    一、能力边界:端侧能做什么,不能做什么

    维度端侧(本地)云端 API
    延迟极低,离线可用依赖网络,通常百毫秒级
    隐私数据不出设备需传输,靠厂商合规背书
    算力上限受显存限制,7B–14B 为主无上限,可跑超大模型
    模型新鲜度更新慢,版本固定周级迭代,永远最新
    长上下文/强推理吃力擅长
    多模态有限语音/图像/视频齐全
    成本结构一次性硬件投入按用量计费

    一句话总结:端侧赢在「近」和「私」,云端赢在「强」和「新」。

    二、三类必须上云的场景

    • 需要最新、最强模型:端侧追不上周级更新的前沿模型,涉及复杂推理、长文档理解时,云端大模型的差距仍然明显;
    • 长上下文与多模态:一份 200 页合同、一段产品视频的理解,本地显存根本装不下,必须交给云端;
    • 多模型择优:不同任务适合不同模型(写作用长文模型、推理用强逻辑模型、批量处理用便宜的开源模型),这种「挑模型」的能力天然在云端。

    三、混合架构:端侧预处理 + 云端兜底

    务实的落地方式不是二选一,而是让端侧做轻量、隐私敏感的前置环节,把重推理统一交给云端接入层。一个最小路由逻辑:

    # 混合路由:端侧先扛轻量,云端兜底重活
    def route(task):
        if task.privacy == "high" and task.flops < EDGE_LIMIT:
            return edge_model.run(task)          # 本地:隐私 + 低延迟
        if task.need == "latest" or task.flops > EDGE_LIMIT:
            return cloud_gateway.call(task)      # 云端:最新模型 / 强推理
        return cloud_gateway.call(task)           # 默认走云端统一接入层

    这种「端侧 + 云端统一接入层」的结构,和文章 《多模型统一接入层实战》里的网关思路一脉相承——区别在于网关后面挂的是云端各家模型。

    四、给企业选型的三条建议

    • 数据分级:先分清哪些数据绝对不能出内网(走端侧/私有化),哪些可以上云换能力(走 API);
    • 先云后端的验证顺序:新需求先用云端 API 跑通业务闭环、验证价值,再评估哪些能下沉到端侧省钱;
    • 用统一接入层降低切换成本:无论端侧还是云端,上层业务都通过同一套接口调用,将来换模型、换厂商不再动业务代码。

    关于「统一接入层」的选型与落地,我们在 《9 月大模型混战,开发者该站谁》里也有一份独立的判断框架。

    把端侧和云端接成一张网,最省事的做法是在 拓瑞智能 trui88.com 用一把 API Key 调度 GPT-6、Claude、DeepSeek 等主流模型,按用量计费、一个后台统一切换——你只管写业务,模型在哪、怎么路由交给接入层。注册即送体验额度。

  • 16 天 5 场发布会:9 月大模型混战,开发者到底该站谁?

    16 天 5 场发布会:9 月大模型混战,开发者到底该站谁?

    9 月刚过半,AI 圈已经打疯了:16 天之内,五家头部厂商轮番召开发布会,平均每三天就有一个「下一代旗舰」登场。对围观群众这是热闹,对开发者却是实实在在的难题——模型越出越多,选型窗口越来越短,接错一次的成本比以往任何时候都高。

    这篇文章带你快速过一遍五场发布会各自亮了什么牌,最后给出三条可以直接写进技术方案的选型结论。

    2026年9月大模型竞技场:五家厂商同台竞技

    一、五场发布会,各家亮了什么牌

    先把 9 月的节奏可视化:从 9 月 1 日 Anthropic 打响第一枪,到 9 月 16 日 Google 收官,整个月的发布密度前所未有。

    动画:2026 年 9 月大模型发布时间轴,五家厂商 16 天内密集上新

    Anthropic · Claude Fable 5.1(9/1)

    打头阵的 Claude Fable 5.1 主打「成本再降 25%」。对长期被 API 账单折磨的团队来说,这比跑分涨 3 个点更有感知——长上下文对话类应用(客服、文档分析)的推理成本直接打了七五折。

    OpenAI · GPT-6 Astra(9/3)

    GPT-6 Astra 的关键词是「AGI 级自主执行」:多步任务的自主规划与工具调用能力大幅增强,官方演示里它独立完成了一次带调试的完整功能交付。这是目前离「Agent 原生」最近的通用模型。

    DeepSeek · V4.1-Flash(9/10)

    真正搅动市场的是 DeepSeek V4.1-Flash:MIT 协议开源,输入价格低至 $0.15/M tokens。对私有化部署和成本敏感的批量任务,这几乎是「直接把底价掀了」。

    xAI · Grok 4.8(9/12)

    Grok 4.8 把参数规模推到 2.5 万亿,主打超长上下文与实时信息检索。需要「今天发生的新闻」进模型的应用,它的时效性优势明显。

    Google · Gemini 3.8 Live(9/16)

    收官的 Gemini 3.8 Live 押注实时语音:毫秒级打断响应与流式多模态,语音助手、通话类产品可以直接基于它重做交互层。

    模型厂商核心亮点最适合的场景价格信号
    Claude Fable 5.1Anthropic成本再降 25%长文分析、客服对话账单敏感型首选
    GPT-6 AstraOpenAIAGI 级自主执行复杂 Agent、自动编码旗舰价
    DeepSeek V4.1-FlashDeepSeekMIT 开源 · $0.15/M私有化、批量任务成本地板价
    Grok 4.8xAI2.5 万亿参数实时信息、超长上下文中高
    Gemini 3.8 LiveGoogle实时语音交互语音助手、通话机器人中
    开发者在多个模型面板之间做选型决策

    二、给开发者的三条选型结论

    • 没有全能冠军,按场景组合。五家旗舰各守一个山头:自主执行看 GPT-6 Astra,长文成本看 Claude Fable 5.1,批量与私有化看 DeepSeek,实时信息看 Grok,语音交互看 Gemini。「一个模型打天下」的方案在 2026 年已经不成立。
    • 成本敏感先看开源。V4.1-Flash 的 $0.15/M 不是营销数字,是真实的地板价。大量非核心链路(预处理、摘要、标注)完全可以下沉到开源模型,把预算留给真正需要旗舰能力的环节。
    • 真正的隐性成本在接入。当业务同时依赖 3 个以上模型,密钥管理、限流重试、故障切换的工程量会迅速超过模型推理本身——这也是「统一接入层」成为标配的原因,我们在下一篇文章里用代码把它讲透。
    支撑大模型混战的 GPU 算力集群

    一句话总结:9 月之后,选型的正确姿势不再是「选哪个」,而是「怎么组合、怎么接入」。

    想第一时间把这几款新模型用到自己的项目里?不必再去五家厂商分别注册、申请密钥、读五份文档——在 拓瑞智能 trui88.com,一把 API Key 即可接入 GPT-6 Astra、Claude Fable 5.1、DeepSeek V4.1-Flash、Grok 4.8 与 Gemini 3.8 Live,按用量计费、控制台统一监控。新用户注册即送体验额度,今晚就能跑通第一个请求。